まな先生解説
こころ質問
すい要点整理
動画編集のテロップをAIで自動生成するには何をすればいい?
全体の流れは4工程
- 工程0:収録前チェック(所要3〜5分) — 冒頭の無音、BGM、話者の重なり、言語設定を確認する。後述の12項目チェックリストを使います。
- 工程1:AI文字起こし(所要1〜3分) — 編集ソフトかYouTubeに素材を読み込ませ、自動生成を実行します。処理時間は尺とツールに依存します。
- 工程2:修正(ここが本番) — 固有名詞・数字・専門用語を一括置換で直し、1行の文字数と改行位置を整えます。
- 工程3:二重書き出し — 焼き込み動画と、字幕データ(SRT/CC)の両方を保存します。片方だけだと後で作り直しになります。
「テロップ」と「字幕」は別物として扱う
- テロップ(焼き込み): 映像に画像として合成された装飾文字。デザインは自由ですが、映像と一体化するため後から文字を直せません。
- 字幕データ(クローズドキャプション/SRT): 映像とは別のテキストデータ。視聴者がオンオフでき、検索・翻訳・自動吹き替えの起点になります。デザインの自由度は低めです。
注意
「テロップを焼き込んだから字幕対応は済んだ」は誤りです。焼き込み文字はテキストデータではないため、YouTubeの自動翻訳やオートダビング(自動吹き替え)の対象になりません。アクセシビリティの観点でもスクリーンリーダーは読めません。両方出す前提で作業してください。
なぜ今テロップなのか(市場の数字)
そもそもAIテロップ自動生成とは?どこまで自動化できる?
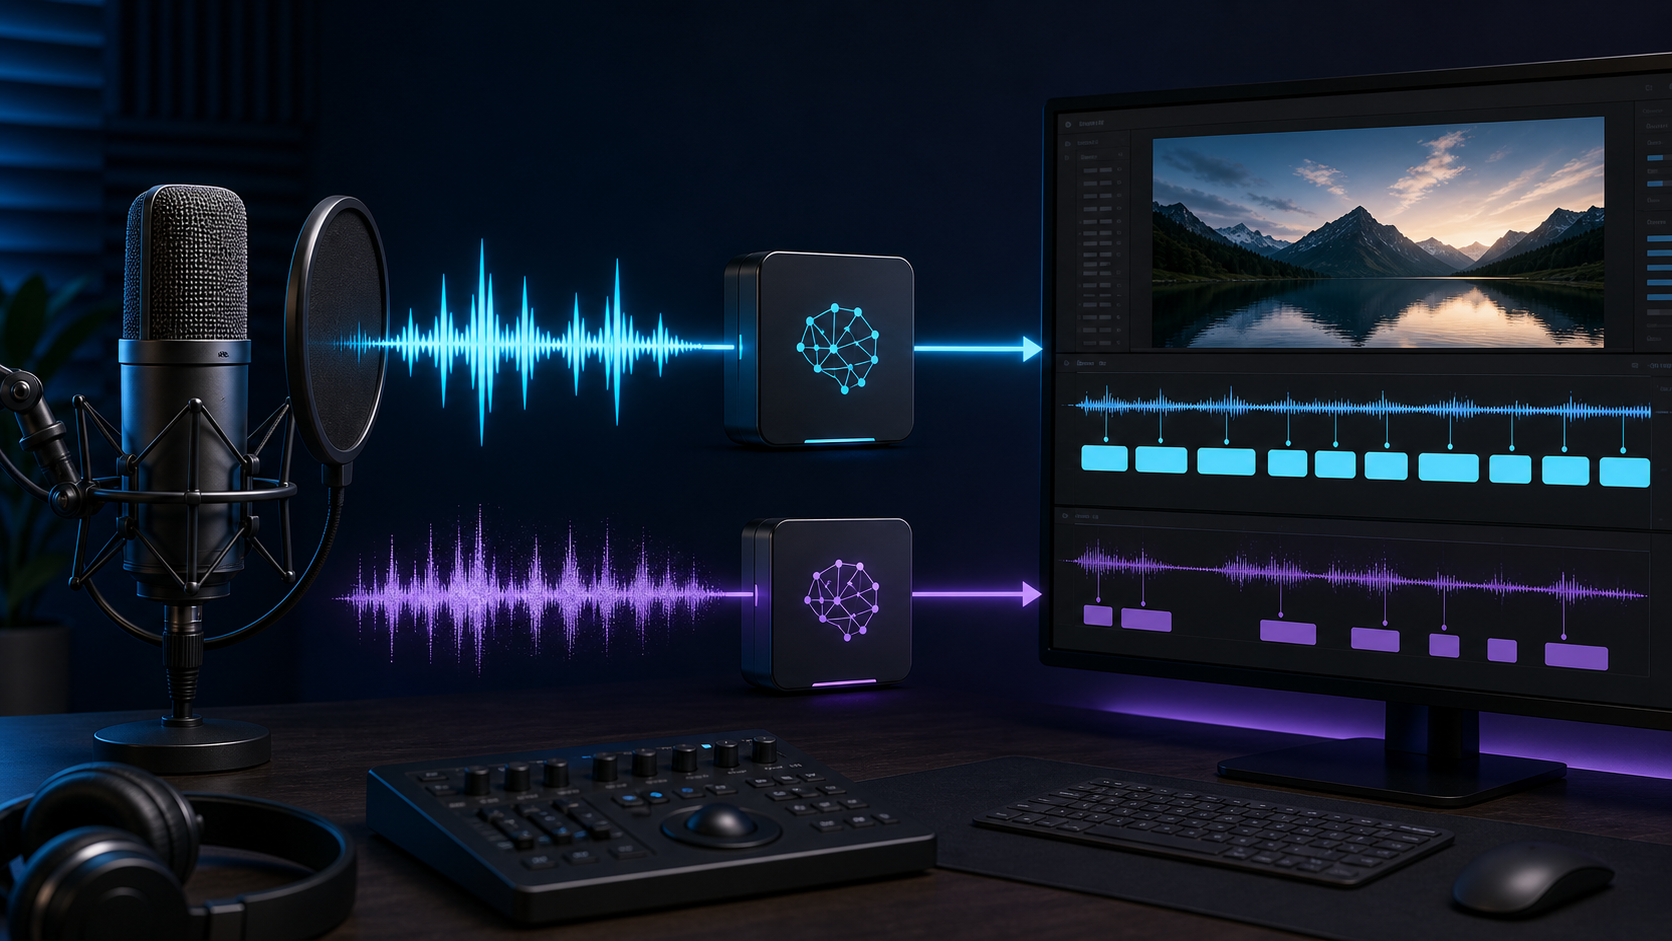
自動化できる領域
- 発話のテキスト化とタイムコード付与(日本語対応。YouTube ヘルプによると自動字幕起こしは日本語を含む100以上の言語に対応)
- 文字数に応じた自動改行と表示尺の割り当て
- フォント・縁取り・背景の一括適用(テンプレート)
- SRTなど字幕ファイルの書き出しと、他ソフトへの読み込み
自動化できない・精度が落ちる領域
- 固有名詞: 社名・商品名・人名・サービス名は学習データにない限り高確率で誤変換されます。
- 同音異義語: 「機能/昨日/帰納」「保証/保障/補償」など。文脈で誤ることがあります。
- 数字と単位: 「いちまんごせん」が「1万5000」か「15,000」かはルールを決めないと揺れます。
- 改行位置: 意味の切れ目ではなく文字数で切られるため、読みづらい行が生まれます。
補足
「AI 動画編集 テロップ」で検索したときに出てくる比較記事の多くは、ここを「多少の誤字は手直しが必要です」の一文で片づけています。実務では、この手直し時間こそが総所要時間の大半です。次章以降で、その時間を構造的に減らす方法を扱います。
字幕は「時短の話」だけではない
始める前に必要なものと、AI自動テロップを一発で通す収録前チェック12項目
- マイク: スマホ内蔵でも成立しますが、ピンマイクや外部マイクがあると誤認識が減ります。
- 静かな収録環境: 空調・キーボード音・屋外の環境音は誤認識の原因です。
- 表記ゆれリスト: 自社の社名・商品名・専門用語と、AIが誤変換しがちな表記の対応表。これが修正時間を最も縮めます。
- 編集ソフトまたはYouTubeアカウント: 後述の使い分け表を参照してください。
収録前チェック12項目(印刷して使えます)
| # | チェック項目 | 守らないと何が起きるか |
|---|---|---|
| 1 | 冒頭の無音を3秒以内にする | 冒頭の長い無音は自動字幕が生成されない原因として公式に挙げられています |
| 2 | BGMは収録時に流さず後乗せにする | 音声に音楽が重なり音質不良と判定され、認識精度が落ちます |
| 3 | 複数人は同時発話を避け、1人ずつ話す(可能ならマイクを分ける) | 音声の重なりは公式が挙げる失敗条件。話者が混ざりテロップが崩れます |
| 4 | 口元とマイクの距離を一定に保つ | 音量が波打ち、小さい箇所だけ文字起こしが欠落します |
| 5 | 長尺は章単位で分割して読み込ませる | 「動画が長すぎる」は公式の失敗条件。処理落ちや未生成が起きます |
| 6 | 動画のデフォルト言語設定を正しくする | 言語の誤検出で、別言語として認識され全文が壊れます |
| 7 | 社名・商品名・専門用語の表記ゆれリストを作る | 修正が1件ずつの手作業になり、修正時間が数倍に膨らみます |
| 8 | 1行あたりの文字数と行数の上限を先に決める | 行が長すぎて読めない、2行を超えて画面を覆うといった事故が起きます |
| 9 | 縦型はUIに隠れる上下領域を避けた表示位置をテンプレ化する | TikTok/ShortsのUIにテロップが隠れ、肝心の一文が読まれません |
| 10 | 数字・単位・英字の表記ルールを統一する | 「1万5000円」「15,000円」が混在し、素人っぽい仕上がりになります |
| 11 | 顧客名・社外秘が映る素材はクラウドAIに上げない | 規約上の権利許諾・機密漏えいのリスクを負います(詳細は後述) |
| 12 | 完成後はCC(SRT)も併せて書き出して保存する | 修正のたびに再書き出しになり、翻訳・吹き替えの起点も失います |
表記ゆれリストの作り方
- 過去の自動生成結果から、誤変換された固有名詞を拾う
- 「読み」ベースで想定される誤変換パターンを追記する(例:「がなんしあ」→「ガナンシア」)
- 編集ソフトまたはテキストエディタの一括置換にそのまま流す
手順を順番に詳しく解説:AIテロップ自動生成のやり方
ステップ1:素材を読み込み、言語設定を確認する
ステップ2:AI文字起こしを実行する
ステップ3:表記ゆれリストで一括置換する
ステップ4:1行の文字数と改行位置を整える
- 1行の文字数: 横型は20字前後、縦型ショートは12〜15字程度を上限に設定すると読みやすくなります
- 行数: 原則2行まで。3行以上は画面を覆い、視聴維持率に響きます
- 改行位置: 助詞や意味の切れ目で改行する(「AIで/テロップを付ける」ではなく「AIでテロップを/付ける」)
縦型ショートのセーフエリア
ステップ5:焼き込みとCC(SRT)の両方を書き出す
動画 字幕 自動生成 無料でどこまで?無料枠はいつ詰むかを計算する
計算式①:自分の月間分析分数を出す
注意
各ツールの料金・無料枠の分数は改定が頻繁です。本記事では特定ツールの金額を断定せず、計算の型のみを示します。実際の数値は必ず各ツールの公式料金ページを直接確認してください。無料枠は「月あたり」か「累計」か、書き出し時にウォーターマークが入るかも要確認です。
計算式②:有料課金は何本目から得になるか
筆者のストップウォッチ実測値(前提条件つき)
| 条件 | 手動でテロップ入力 | 収録チェック+AI生成+修正 | 削減時間 |
|---|---|---|---|
| BGMなし(収録時に音楽を流さない) | 約120分 | 約28分(チェック4分+生成3分+修正21分) | 約92分 |
| BGMあり(収録時に音楽が流れている) | 約120分 | 約47分(チェック4分+生成3分+修正40分) | 約73分 |
つまずきやすいポイントと自動字幕の精度を上げる方法
症状別の対処表
| 症状 | 主な原因 | 対処 |
|---|---|---|
| 自動字幕がまったく生成されない | 冒頭の無音が長い/尺が長すぎる/言語未対応 | 冒頭の無音をカットして3秒以内に。長尺は章分割 |
| 前半だけ正確で後半が崩れる | 話者の疲れによる滑舌低下/マイク距離の変化 | 収録を分割し、マイク位置を固定する |
| 固有名詞だけが毎回誤変換される | 学習データに存在しない語 | 表記ゆれリストで一括置換(修正しきる発想を捨てる) |
| 全文がローマ字や別言語になる | デフォルト言語設定の誤り | 言語設定を修正して再生成 |
| 対談・複数人の箇所だけ壊れる | 同時発話による音声の重なり | 1人ずつ話す。可能ならマイクを分けて別トラックで収録 |
| BGMがある箇所の精度が落ちる | 音楽と音声の混在 | BGMは収録時に流さず編集で後乗せ |
精度を上げる話し方の実務
- 文末まで言い切る — 語尾が消えると助詞や述語が欠落します
- 文と文の間に0.5秒の間を置く — 文の区切りが正しく認識され、改行位置も整います
- 早口を避ける — 参考として、YouTube ヘルプ「オートダビングを使用する」(2026)は自動吹き替えの対象外条件に「発話ペースが速すぎる」を挙げています。音声認識全般で不利になる要素です
- 数字は単位まで読む — 「じゅうごせん」ではなく「1万5000円」と読み切る
注意
修正フェーズで「完璧に直そう」とすると時間が無限に伸びます。優先順位は ①固有名詞 → ②数字 → ③助詞の誤り → ④句読点 です。視聴者の理解に影響しない微細な差異は割り切ってください。
長尺・多言語での制約
焼き込みテロップと字幕データ(CC/SRT)はどちらを選ぶべき?
| 用途 | 推奨する出力形式 | 自動翻訳・オートダビングの起点になるか | WCAG 1.2.2/合理的配慮の観点 | クラウドAIへのアップロード可否 | 修正時のやり直しコスト | 第一候補ツール |
|---|---|---|---|---|---|---|
| YouTube長尺 | 両方(焼き込み+CC) | ○ CCのみ起点になる(オートダビングは120分超が対象外/YouTubeヘルプ) | CC必須。WCAG 1.2.2は収録済み同期メディアへのキャプション提供を求める(WAIC) | 可。ただし社外秘が映る場合は限定公開でも要検討 | 焼き込みは再書き出し必須/CCはテキスト差し替えのみ | YouTube標準の自動字幕+編集ソフトの焼き込み |
| 縦型ショート | 焼き込み優先(可能ならCCも) | △ プラットフォーム依存。CCがあれば有利 | 焼き込みのみでは不十分。CC併用が望ましい | 可。ただしCapCut等は規約要確認(後述) | 焼き込み中心のため再書き出し前提 | 縦型テンプレートを持つスマホ編集アプリ |
| 自社サイト・LP埋め込み動画 | CC必須+焼き込み任意 | ○ CCがあればテキスト資産になる | CC必須。デジタル庁ガイドブック(2025)がキャプション・書き起こしテキストの提供を挙げる | 可。ただし未公開の商品情報は要注意 | CC中心なので差し替えが容易 | SRT書き出しに対応した編集ソフト |
| 社内・顧客情報を含む動画 | ローカル処理で両方 | ― 外部公開しない前提 | 社内向けでも合理的配慮の対象になり得る(2024年4月義務化/内閣府) | 原則不可。規約上の権利許諾と機密性を確認 | ローカル処理のため制約は少ない | ローカル完結型の編集ソフト |
なぜ「両方出す」が基本なのか
- 修正コストが非対称 — 焼き込みは1文字直すだけで再書き出しですが、CCはテキストを直すだけです
- 後段の資産化 — 自動翻訳・オートダビング・全文検索の起点はCCです。焼き込みは画像なので何にもつながりません
- 視聴環境の多様性 — 音を出せない環境では焼き込みが効き、読み上げ環境や翻訳ではCCが効きます
補足
SRTファイルは中身がただのテキストです。開けば「連番/タイムコード/本文」の繰り返しで、テキストエディタで直接編集できます。ソフトを立ち上げずに誤字を直せるのは実務で地味に効きます。
注意点・リスク:クラウドAIに上げてよい素材、いけない素材
利用規約のライセンス条項を確認する
注意
規約の解釈はサービス・地域・改定時期によって異なります。本記事は特定サービスの是非を断定しません。受託案件やクライアント素材を扱う場合は、必ず自分で最新の規約本文を確認してください。第三者の解説記事ではなく、一次資料である規約ページを読むのが原則です。
判断のための3つの問い
- この動画に、顧客・取引先の名前や顔、非公開の情報が映っていないか
- クライアントとの契約に、成果物や素材の第三者提供を制限する条項がないか
- このサービスの規約は、アップロードした素材をサービス改善やAI学習に使う可能性を示していないか
誇張表現と事実確認のリスク
具体例:個人事業主と中小事業者、2つのケーススタディ
ケース1:副業でYouTube長尺を月4本出す個人
ケース2:中小事業者が商品紹介の縦型ショートを月20本出す
- 月20本のテンプレート適用を手作業でやると、生成の時短効果が消える
- 縦型のセーフエリア設定をテンプレ化しないと、毎回の位置調整で時間を食う
効率化・応用のコツ:テンプレート化と資産化
テンプレート化する対象
- フォント・サイズ・縁取り・背景の帯(横型用と縦型用の2種)
- 1行の文字数上限と行数上限
- 縦型のセーフエリアを避けた表示位置
- 話者ごとの色分け(対談形式がある場合)
SRTを資産として使い回す
- ブログ記事の下書き — 全文テキストなので、整えれば記事素材になります
- 他ソフトへの引き継ぎ — 別の編集ソフトに読み込ませて再デザインできます
- 翻訳の起点 — 多言語版を作る際、CCがあれば翻訳フローに乗ります
- 全文検索 — 過去動画のどこで何を話したかを検索できます